
モバイルアプリ開発者 · Android & Flutter
補足: 本記事は AI(Claude)が私の最初のメモと着想をもとに仕上げたものです。
前回の「待つのは一つだけ」は、一つのことを認めて終わっていた。モデルが八段すべてを守りきる保証は出せない。だから次は、ルールを増やすことじゃない。どれだけ守られているかを測ることだ。
今回はその測定から得たことを書く。結論を先に言う。点数をつけるのは簡単だ。難しいのは分母を決めることだ。分母を三度直した。点数は 11% から 24% まで上がった。その間、モデルの振る舞いは一度も変わっていない。一度も、だ。
どのルールにも、セッションの記録の中に痕跡が残る。ゲートのブロックが書かれたか。審査の判決行が現れたか。テストの結果が error を返したか。測り方はこうだ——すべてのセッションの記録を引き出し、区間に切って、区間ごとに問う。このルールはここで発火すべきだったか。発火したか。
分子は「発火した」区間の数。分母は「発火すべきだった」区間の数。分子はまず間違えない。痕跡は痕跡だから。落とし穴は、全部分母にある。
最初の版は、何かしら手を動かした区間をすべて「審査対象」の分母に数えていた。よく見ると、163 の区間は git commit、mkdir、install.sh、tee の類しか走らせていない。分母の三割を占めて、遵守率は 1%。
1% で当然だ。これらの区間には審査する作品がない。ルールはそもそも、そこで発火するはずのものじゃなかった。外したら、遵守率は 11% から 15% に動いた。
雑音を取り除いても、まだ何かがおかしい。審査対象の 390 の区間のうち 58 で、判決行は区間の中にはある。ただし最後の編集の後にはない。
追っていくと、区間の境界が間違っていた。隣り合う二つの仕事が一つの区間に畳まれていたのだ。一つ目は完了し、審査され、判決が書かれた。続いて二つ目が編集を始め、審査なしで終わった。一つの区間として読めば、最後の編集の後に判決はない。落第。
でもこの読み、まったく逆さまだ。審査を受けた一つ目が減点され、審査を受けていない二つ目は同じ区間に隠れて、一度も数えられていない。ひどい話だ。
直し方は「判決が書かれた瞬間に区間を閉じる」。これで遵守率は 15% から 24% に動いた。
三つの数字を並べてみる。
| 分母 | 遵守率 | モデルの振る舞い |
|---|---|---|
| コマンドのみの区間を含める | 11% | — |
| コマンドのみの区間を外す | 15% | 変わらず |
| 判決が書かれた時点で区間を閉じる | 24% | やはり変わらず |
毎回、分母が真に近づいただけだ。規律が良くなったわけじゃない。これがこの記事の背骨だ。「エージェントの遵守率」という数字を見ても、まだ信じるな。まずその分母が誰で、いつ変えられたかを問う。分母の履歴を持たない点数は、先月と比べられない。それだけの話だ。
二つ目の落とし穴は、分母の話じゃない。誰が誰を採点しているか、の話だ。
ルールはこう書いてある。審査で指摘が出たら、まず直す。直してから完了報告を書き、最後の行に Compliance Review: PASS と記す。ルール自体は正しい。だが測定が読むのがその行なら、結果は 100% にしかなりえない。その行を書くのは、審査される側であるメインの流れ自身だ。メインの流れは、自分が通ったと思えるまで書かない。これは測定じゃない。自問自答だ。
だから判決は、審査者自身の記録から読むしかない。派遣された、読み取り専用の、メインの流れと記憶を共有しないエージェントが実際に何を言ったか。メインの行は主張だ。審査者の記録が証拠になる。
同じ落とし穴は、ゲートの受入率にも姿を変えて現れる。ゲートが止まって人を待つとき、ユーザーはいくつかの選択肢から一つを選んで答える。「一つ選んだ」を常に「計画を受け入れた」と数えたら——計画がどれほど雑でも、分母の十分の一は構造的に 100% に張り付く。
判定を二つの層に分けた。構造的な判定は tool_result の error フラグだけを読む。出力文字列はいっさい解析しない。書式の変更で壊れることはない。頼もしく聞こえる。
そこへ前回の落とし穴が戻ってきた。今度は数字を連れて。
flutter analyze 2>&1 | tail -6
set -o pipefail がなければ、shell が返すのは tail の終了ステータスだ。記録を横断して見ると——pipe を通した lint 実行の 99% が「クリーン」を返していた。linter が何を捕まえていようが関係なかった。これを通過と数えるわけにはいかない。「測定不能」という別枠を設けた。その行の下に印字し、どちらの側にも数えない。
同じ行から、小さいものもいくつか出てきた。
command -v による探査が分母に紛れ込んでいた。どれも「失敗」していた。理由は、その機械にツールが入っていなかっただけ。tsc を裸の単語で照合すると、grep -n tsc file も型検査として数えられる。しかも grep の終了ステータスを借りて、通過を捏造する。構造的とは「モデルの読みに頼らない」という意味だ。「間違えない」という意味じゃない。
三つ目の落とし穴。測定が確信を持てないとき、どうするか。私の答えは、どちら側にも数えず、別に記録すること。
ゲートは書かれた。でもユーザーは答えず、セッションが終わった。これは受入でも拒否でもない。abandoned と記録する。沈黙は計画への判決じゃない。
ユーザーがバグを報告した。でもそれがどの「完了」に属するか、確かじゃない。最新のものを指していると仮定するくらいなら、捨てる。その行は、そのぶん過大評価していることを正直に認めて、帰属できなかった件数を下に印字する。
データを捨てるのは痛い。でも一つの誤った帰属は、行全体の数字を間違った方向へ傾ける。しかも、それは見えない。これがいちばん厄介なところだ。
前に言った通り、判定は二層ある。構造的な層は終了ステータスを読む。発見的な層は記録の一区間をモデルに渡して、意図を判断させる(セッションとターン単位でキャッシュし、二度は訊かない)。
二つの信頼度、大きく違う。だから見出しの数字は二つに分けて出す。一つの平均で確からしさを装ったりしない。モデル別にも切っている。Opus、Sonnet、Fable、それぞれ一列。「モデルはルールを忘れる」はもともとモデルについての話だ。混ぜたら差が見えなくなる。
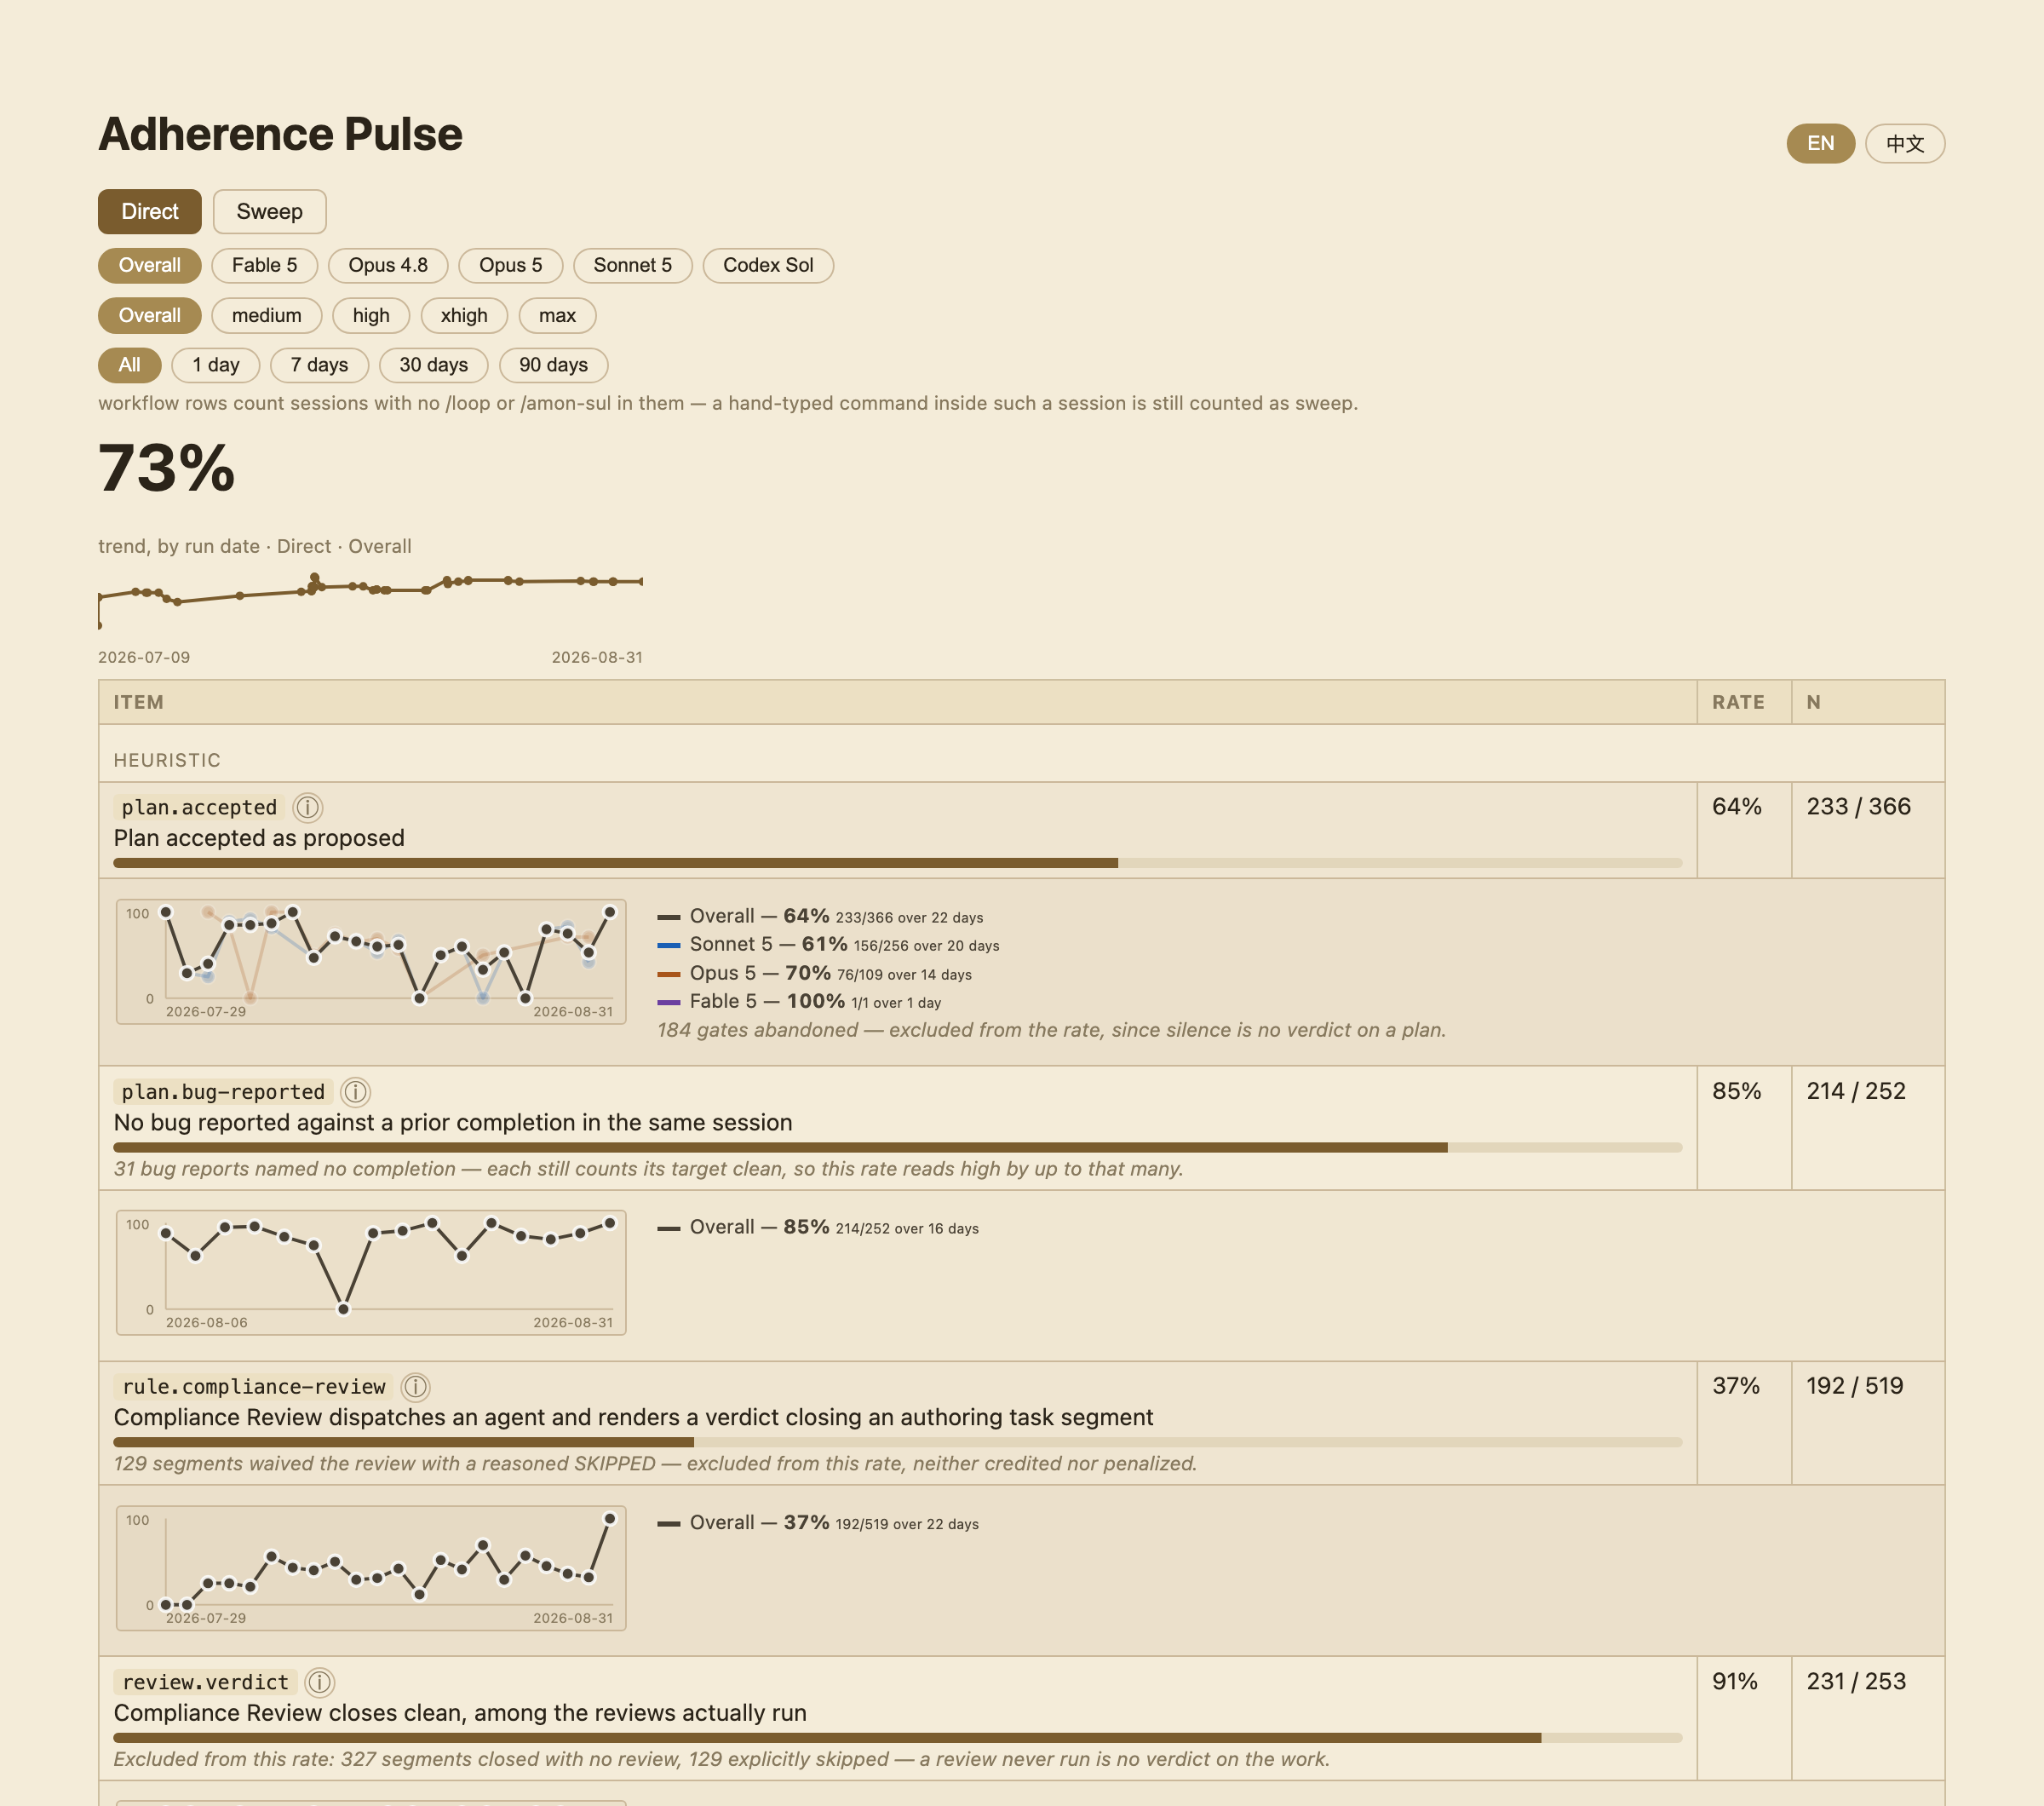
2026-08-31 時点のダッシュボードだ。各行の下の小さな文字——それが分母から外されたものだ。コンプライアンス審査の行は、これを書いている時点でもう 37% まで来ている。
三つ、先に言っておく。
発見的なほうの半分は、モデルがモデルを判定している。ないよりはましだ。でも、その分母を決めているのも私だ。
lint の行は、いま分母がいちばん薄い。短期の揺れを傾向だと思わないこと。
そして、これらの比率はいまなお規律の証明じゃない。証明しているのは、痕跡が残ったかどうかだけだ。ルールは、痕跡を残さずに守られることもある。痕跡だけ残して、守られていないこともある。この区別は忘れないようにしている。
エージェントが規律を守っているか知りたい?なら、まず点数を見ないこと。先に三つ問う。この点数の分母は誰か。誰が誰を採点しているか。分からないとき、それはどうするか。三つとも答えが出て初めて、その数字は意味を持ちはじめる。